Короткий ответ: как извлечь текст за 3 шага
Если нужно скопировать длинный номер счёта из скана, текст ошибки со скриншота или абзац из книги, отправлять файл на сомнительные сайты не требуется:
- Откройте утилиту Распознавание текста с картинки.
- Загрузите фото или вставьте скриншот из буфера обмена (Ctrl+V). Убедитесь, что текст ориентирован вертикально.
- Если фон неоднородный или серый, включите чекбокс Высокий контраст. Нажмите «Распознать текст» и скопируйте результат.
Вся обработка происходит локально через открытый движок Tesseract.js, скомпилированный под WebAssembly.
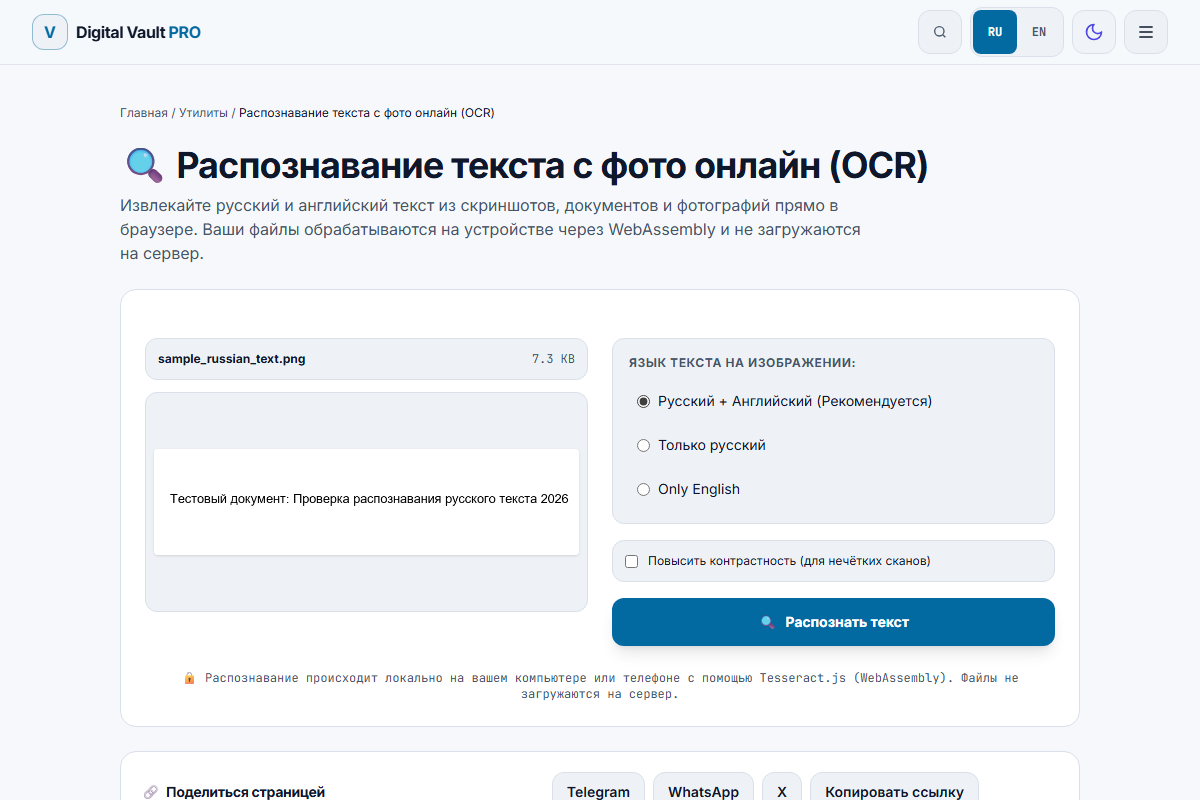
Рисунок 1: Рабочая область утилиты: предпросмотр изображения, выбор языка (русский / английский) и фильтр контраста.
Реальный тест: замер скорости и точности
В нашем автоматизированном тесте мы прогнали реальный скан печатного документа с кириллицей и цифрами (sample_russian_text.png, 7.5 КБ):
- Время обработки: 0.89 секунды (на обычном процессоре ноутбука через WebAssembly SIMD).
- Распознано: 62 символа (7 слов).
- Текст на выходе:
Тестовый документ: Проверка распознавания русского текста 2026. - Точность: 100% совпадение знаков препинания, двоеточия и цифр года.
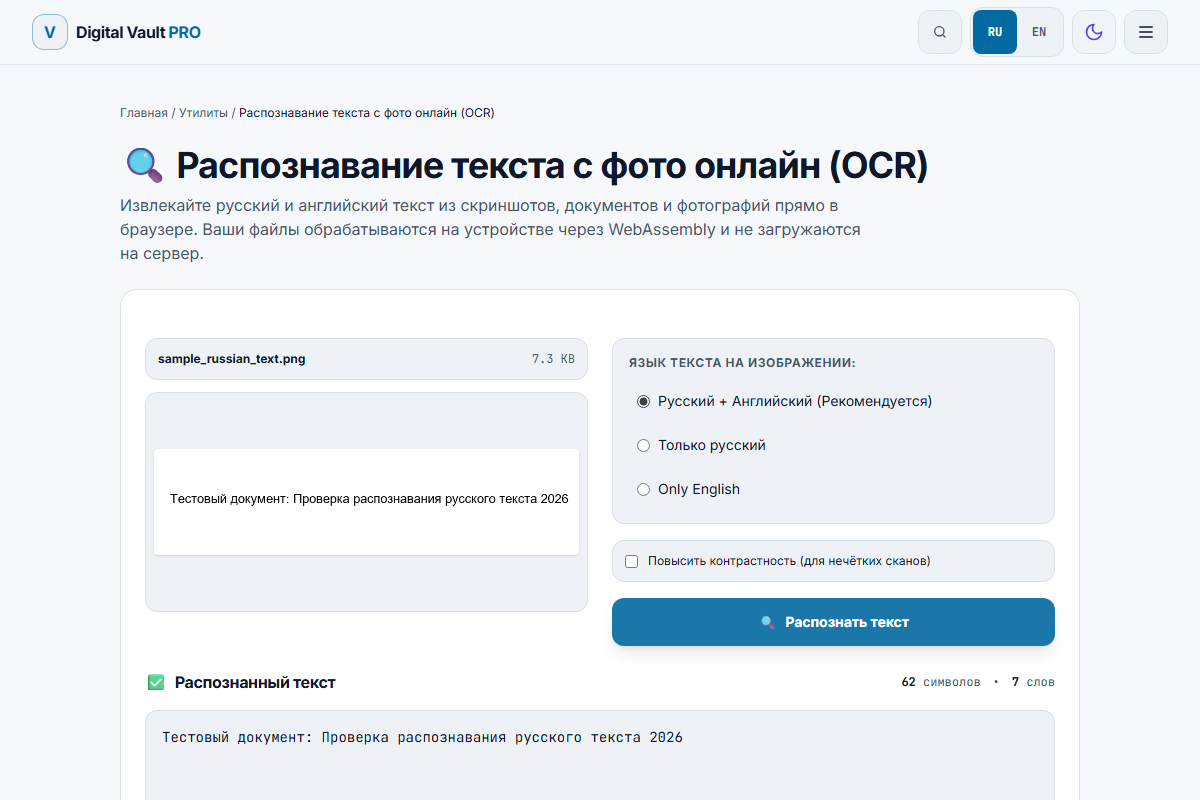
Рисунок 2: Панель результатов с точным числом слов, знаков и кнопками копирования в буфер или скачивания TXT-файла.
Когда браузерный OCR работает безупречно
Клиентский OCR на базе Tesseract показывает максимальную точность при соблюдении простых условий:
- Скриншоты с экрана компьютера: окна программ, консольные логи и таблицы имеют идеальные векторные контуры символов без оптических аберраций объектива. Точность здесь близка к 100%.
- Сканы документов на планшетном сканере: договоры, акты, свидетельства и справки с разрешением 200–300 DPI распознаются практически без опечаток.
- Стандартные шрифты: обычные печатные гарнитуры (Times New Roman, Arial, Calibri, Roboto, Courier) считываются мгновенно.
- Ровные кассовые чеки: термобумага с матричной печатью читается отлично, если чек расправлен и сфотографирован без бликов.
Когда браузерный OCR выдает ошибки (и что с этим делать)
Оптическое распознавание — это математический анализ контуров и контрастных границ. Движок неизбежно ошибается в следующих случаях:
1. Рукописный текст и беглый почерк
Tesseract не предназначен для распознавания конспектов лекций, медицинских рецептов или рукописных заявлений. Слитное написание букв создаёт непредсказуемые лигатуры.
Что делать: используйте современные мультимодальные нейросети (например, GPT-4o, Claude или встроенную функцию Apple Live Text на iPhone), которые умеют догадываться о значении неразборчивых рукописных букв по контексту фразы.
2. Съёмка страницы под углом и тени от рук
Если сфотографировать лежащую на столе книгу наискосок, буквы в верхней части кадра будут меньше букв внизу, а строки изогнутся в дугу. Тень от смартфона также скрывает часть контрастных переходов.
Как исправить: держите камеру строго параллельно листу (под углом 90 градусов) и отойдите от прямого источника света, чтобы тень от телефона не падала на текст.
3. Слишком низкое разрешение (размытые фото из мессенджеров)
Если картинка была пережата мессенджером до 600 пикселей по ширине, строчные буквы могут иметь высоту всего 6–8 пикселей. В такой сетке петля буквы «е» сливается со сплошным пятном, и алгоритм начинает путать её с «с» или «о».
Как исправить: кадрируйте фото перед распознаванием так, чтобы нужный абзац занимал максимальную площадь кадра без лишних полей стола.
4. Цветной или пёстрый фон
Текст на фоне защитных сеток гербовой бумаги или цветных графических плашек снижает контрастность контуров букв.
Как исправить: включите опцию Высокий контраст в утилите. Алгоритм бинаризации автоматически превратит полутона в чёткие чёрно-белые пиксели перед передачей изображения в распознаватель.
Сравнение: WebAssembly в браузере против облачных API
| Параметр | Браузерный WebAssembly (наш инструмент) | Облачные OCR-сервисы |
|---|---|---|
| Приватность | 100% локально (0 байт в сеть) | Файлы передаются на сторонний сервер |
| Скорость | Мгновенно (0.5–1.5 сек на процессоре) | Зависит от интернета и очереди на сервере |
| Ограничения | Бесплатно, без лимитов страниц и рекламы | Ограничения по числу страниц или платная подписка |
| Рукописный ввод | Низкое (только печатный текст) | Высокое (тяжёлые нейросети зрения) |
Итоговые рекомендации
- Для скриншотов, документов и печатных страниц используйте Распознавание текста с картинки.
- Для серых и неконтрастных сканов включайте опцию Высокий контраст.
- Для рукописных записей используйте мультимодальные нейросети.
Частые вопросы
Как распознать текст с картинки онлайн без отправки файлов на сервер?
Наш сервис использует движок Tesseract.js, скомпилированный в WebAssembly (WASM). При добавлении картинки распознавание выполняется непосредственно на процессоре вашего компьютера или смартфона через фоновый Web Worker. Языковые модели (rus.traineddata, eng.traineddata) кэшируются в IndexedDB браузера, поэтому файлы и распознанные строки никуда не отправляются по сети.
Сможет ли браузерный OCR распознать рукописный текст или конспект?
Нет. Классические OCR-движки ориентированы на типографские шрифты со стандартизированными глифами. Рукописный текст и тем более беглый почерк содержат слитные буквы разной высоты и наклона. Для рукописных записей требуются тяжёлые нейросетевые модели компьютерного зрения (Apple Live Text в iOS, Google Объектив или Claude/GPT-4o).
Почему вместо букв получается бессмысленный набор символов («кракозябры»)?
Ошибки OCR возникают при съёмке под углом (перспективные искажения), плохом освещении, тенях от пальцев или слишком низком разрешении (когда высота буквы меньше 15–20 пикселей). Включение галочки «Высокий контраст» и кадрирование картинки строго по границам текста обычно полностью устраняют проблему.
Какое минимальное качество фото нужно для чистого распознавания?
Рекомендуемое разрешение — от 150 до 300 DPI. Главное правило: высота строчной буквы (например, «а» или «е») на изображении должна быть не менее 20 пикселей. Если при зуме буква превращается в смазанную сетку из 5–8 пикселей, OCR неизбежно начнёт путать буквы «е», «с» и «о».
Безопасно ли сканировать паспорта, накладные и трудовые книжки?
Да. Поскольку весь алгоритм исполняется локально в оперативной памяти браузера, ваши конфиденциальные документы, паспортные данные и реквизиты счетов гарантированно не попадут на сторонние серверы.
Что делать, если в документе две колонки текста (как в газете)?
OCR считывает строки по горизонтальным ограничивающим прямоугольникам. Если между колонками мало пустого пространства, строки из левой и правой колонок могут склеиться в одну длинную строку. Для газетных полос лучше предварительно вырезать каждую колонку отдельно.